信任機器
從一臺電腦到一座電廠,與寫進程式的減半。光有理想不夠,它得真的轉起來。這一幕拆開比特幣這臺「信任機器」:礦工拼算力競爭記帳,全球成千上萬個節點各自獨立驗證同一套規則,記錄越往後越改不動——於是沒有中心,陌生人也能共享一本誰都賴不掉的帳。
每一代真實礦機(CPU→GPU→FPGA→ASIC)· 全網算力與難度增長史 · 三次真實共識事件的一手報告與鏈上記錄。
這本帳之所以難以改寫,是因為全網靠「算力競賽 + 共識規則」共同維護同一本帳——沒有單一主體說了算,改寫的代價隨全網算力上升。這一論證也有已知的侷限,見本廳「51% 攻擊」展項中的「仍有爭議的部分」。
一臺機器如何運轉
五個零件缺一不可信任機器總覽
先見森林,再看樹木。把這套系統當作互相咬合的齒輪——五個零件缺一不可,合起來才讓「無需信任」成立。看完全貌,再進入下方各展項鑽一個零件。
公共帳本
一本人人可查、人人各存一份的帳。
密碼學連結
區塊環環相扣,改一處則後面全廢。
工作量證明
誰想記帳,先付出真實算力與電力。
最長鏈共識
全網預設認可累積工作量最多的那條鏈。
激勵設計
誠實記帳有獎勵,作弊成本遠大於收益。
人類雜湊挑戰
雜湊把任意資料壓成一串固定長度的「指紋」,無法倒推。挖礦就是不停換一個數字重算雜湊,直到碰上足夠小的結果——沒有捷徑,只能硬試。瘋狂點選,感受一下。
工作量證明與難度調整
算力漲了上百萬億倍,出塊速度卻始終約十分鐘一個——因為規則會自己糾正。每 2016 個區塊(約兩週),全網根據前一輪的實際耗時自動調整難度:出塊太快就調難,太慢就調易。沒有委員會開會,沒有人下命令,這是一套寫進程式碼的自我調節機制。
減半大鐘
距離下一次比特幣減半,還有——
出塊獎勵——礦工每寫入一個區塊獲得的新幣,也是新幣的唯一來源——每 21 萬個區塊減半一次:50 → 25 → 12.5 → 6.25 → 3.125 BTC。總量 2100 萬枚的上限,不靠任何機構承諾,而是這條減半規則的數學後果。稀缺,是被程式執行的。
一筆交易如何在無人信任下被全網確認
跟隨一筆真實交易走完全程。每一步只問一件事:這裡本來該信任誰?——又是被什麼機制替代了?
發起
你用私鑰簽名,證明「是我本人」。
廣播
交易傳遍全球節點,進記憶體池。
打包
礦工競爭算力,贏家打包進區塊。
確認
全網同步,越往後越不可逆。
| 這裡本來該信任誰 | 被什麼機制替代了 | |
|---|---|---|
| 信任銀行核對你的餘額 | → | 全網公開帳本 + 密碼學簽名 |
| 信任某人誠實記帳 | → | PoW 算力競爭 + 最長鏈規則 |
| 信任大家不作弊 | → | 激勵設計:作弊成本 > 收益 |
為什麼這本帳很難改寫
從「同一筆錢花兩次」說起雙花問題的解答
數位資訊能隨意複製,一筆數位貨幣憑什麼不能複製一份、花兩次?過去靠銀行這樣的記帳人核對餘額;沒有記帳人怎麼辦?這就是「雙花問題」。
中本聰的答案不是「找一個更可信的人」,而是「讓時間順序本身變得昂貴」。所有交易被公開廣播、按順序打包進區塊,而寫下一個區塊必須付出真實的算力。想讓同一筆錢花第二次,你就得推翻已經寫好的順序——也就是要重做那之後全部的工作量,並且跑得比全世界剩下的算力還快。雙花沒有被禁止,它只是被做成了一件在經濟上划不來的事。
不可篡改性
每個區塊的頭部都寫著上一個區塊的雜湊值。這意味著任何一個位元組的改動,都會讓它的雜湊變樣,從而讓下一個區塊指向的地址失效——連鎖反應一直傳到鏈尾。所以要改寫第 N 個區塊,你必須重做第 N 個之後所有區塊的工作量,同時還要追上全網正在往前推進的速度。不是「不允許改」,是「改不動」。
雜湊指標
每個區塊頭含前一區塊雜湊,篡改立刻暴露。
累積工作量
改一個區塊,要重做其後全部 PoW——工作量隨深度不斷累加。
越久越硬
區塊埋得越深,重寫它需要的算力越接近不可能。
共識規則 · 節點在驗證什麼
這是全場最容易被誤解的一點:礦工並不決定規則,節點才是。礦工只負責「提議」——把交易打包成區塊。而全球每一個全節點都會獨立地、逐條地驗證這個區塊:簽名對不對、有沒有雙花、金額是否守恆、獎勵有沒有超發、區塊大小是否合規。任何一條不過,區塊直接被丟棄,無論提議者有多少算力。「不信任,去驗證」不是一句口號,它是每個節點每十分鐘都在做的事。
- 簽名有效性
- 無雙花
- 發行量守恆
- 工作量達標
簽名有效性
每筆輸入是否由對應私鑰合法簽署。
無雙花
被花掉的 UTXO 是否確實未被動用過。
發行量守恆
出塊獎勵是否等於目前減半週期允許的額度。
工作量達標
區塊雜湊是否滿足目前難度目標。
礦工提議,節點裁決。這就是為什麼「算力大」不等於「說話算數」。2017 年的區塊大小之爭中,結局並非由礦工單方決定,各方作用至今仍有爭議,經過見「榮耀與災難」中的「區塊大小之戰」展項。
最長鏈規則與分叉收斂
兩個礦工幾乎同時挖出區塊,網路會短暫地出現兩條鏈——這不是故障,而是設計允許的常態。節點各自先接受先收到的那個,然後繼續挖。下一個區塊出現在哪一邊,那一邊就更長,另一邊被拋棄,其中的區塊成為「孤塊」。分歧靠算力自動收斂,不需要任何仲裁者。這也解釋了「確認數」:你的交易上面壓了越多區塊,被回滾所需的算力就越荒謬。
孤塊 · 交易回到記憶體池
網路正常延伸
臨時分叉
同時出塊導致兩條候選鏈,屬正常現象。
孤塊
落敗那條鏈上的區塊被全網丟棄,其交易回到記憶體池。
為什麼等 6 個確認
每多一個確認,算力佔少數的攻擊者追上的機率就按指數下降——等待即安全。
記帳大冒險 · 51% 攻擊
想改寫帳本,靠的不是「多開幾個節點」,而是算力。拖曳滑桿扮演攻擊者——看看湊齊相應算力的代價,以及按白皮書 §11 的公式,這些算力換來的實際勝算是多少。
靠算力,不是靠開節點
跑一個節點很便宜,它只負責按規則驗證交易;真正能改寫帳本的,是「誰的算力/工作量最多」。要可靠地發動攻擊,必須掌握全網 >50% 的算力;算力不足一半也有成功可能,但機率隨確認數增加迅速下降。
算力總量巨大,分佈隨時間變化
全網算力來自全球數以千計的礦工與礦池。要過半,需購置並運轉超過其餘所有參與者總和的 ASIC,硬體與電費達數百億美元量級。但算力的集中程度並非恆定,礦池份額的歷史變化見本廳「礦池與算力集中」。
即便做到也偷不到什麼
你最多只能雙花自己近期的交易、或暫時審查某些交易;無法憑空造幣、無法偷走別人的幣、無法改寫久遠的歷史。
攻擊的收益演算
白皮書第 6 節的論證是:即便掌握多數算力,按規則挖新幣也比破壞系統更划算,因為系統一旦被破壞,攻擊者自己的幣也會貶值。後續文獻(如 Budish 2018)補充:攻擊還會讓只能用來挖礦的礦機跟著貶值。這一論證在什麼條件下成立,見下方「仍有爭議的部分」。
越久的帳越改不動
要推翻越早的區塊,就得重做它之後的全部工作量,工作量隨深度累加,少數算力追上的機率指數級下降;何況社群還能檢測到異常並聯手反制。
仍有爭議的部分
上述五點是這一設計的主流論證,但並非定論。①「必須過半」受到質疑:Eyal 與 Sirer 2013 年提出的「自私挖礦」主張,在特定條件下低於 50% 的算力亦可獲得超額收益。② 攻擊者未必需要自建礦場:算力租賃市場使短時租用成為可能,以太坊經典與 Bitcoin Gold 上已實際發生過此類重組。③ 第 4 點的收益演算以攻擊者持有礦機為前提;若其同時持有空頭部位,該演算不成立(Budish 2018)。本館並陳這些論述,不就何者成立作出判斷。
算力競賽
從一臺電腦到一座電廠礦機進化牆
從一臺電腦到一座電廠——挖礦裝置的進化史。CPU→GPU→FPGA→ASIC 四代,每代都因下一代更高的算力與能效比而被淘汰。
逐代機型編目 · 規格與來源
每臺機器都註明規格出處與影像來源。

通用 x86 CPU · 範例 Intel Core i7-920
全牆唯一一件本身不是礦機的展品——一顆普通桌上型電腦處理器。中本聰正是用 CPU 挖出創世區塊的。它的意義不在效能,而在門檻為零:任何有電腦的人都能參與,算力分佈最均勻。這是比特幣唯一一段「不必購置任何專門裝置」的時期,此後再未重現。

AMD/ATI Radeon HD 5870
GPU 時代主力礦卡,平行架構算 SHA-256 比 CPU 快數十倍,一舉讓 CPU 挖礦失去意義。這一代礦工幾乎只買 A 卡——AMD 的 VLIW 架構帶 BFI_INT/bitalign 指令,單條指令即可完成 SHA-256 所需的位旋轉,NVIDIA 要用三條,再加上運算單元更多,A 卡挖礦總體快 3–5 倍。挖礦自此與特定硬體綁定:買錯牌子就挖不動。同期雙晶片旗艦 HD 5970 約 700 MH/s。
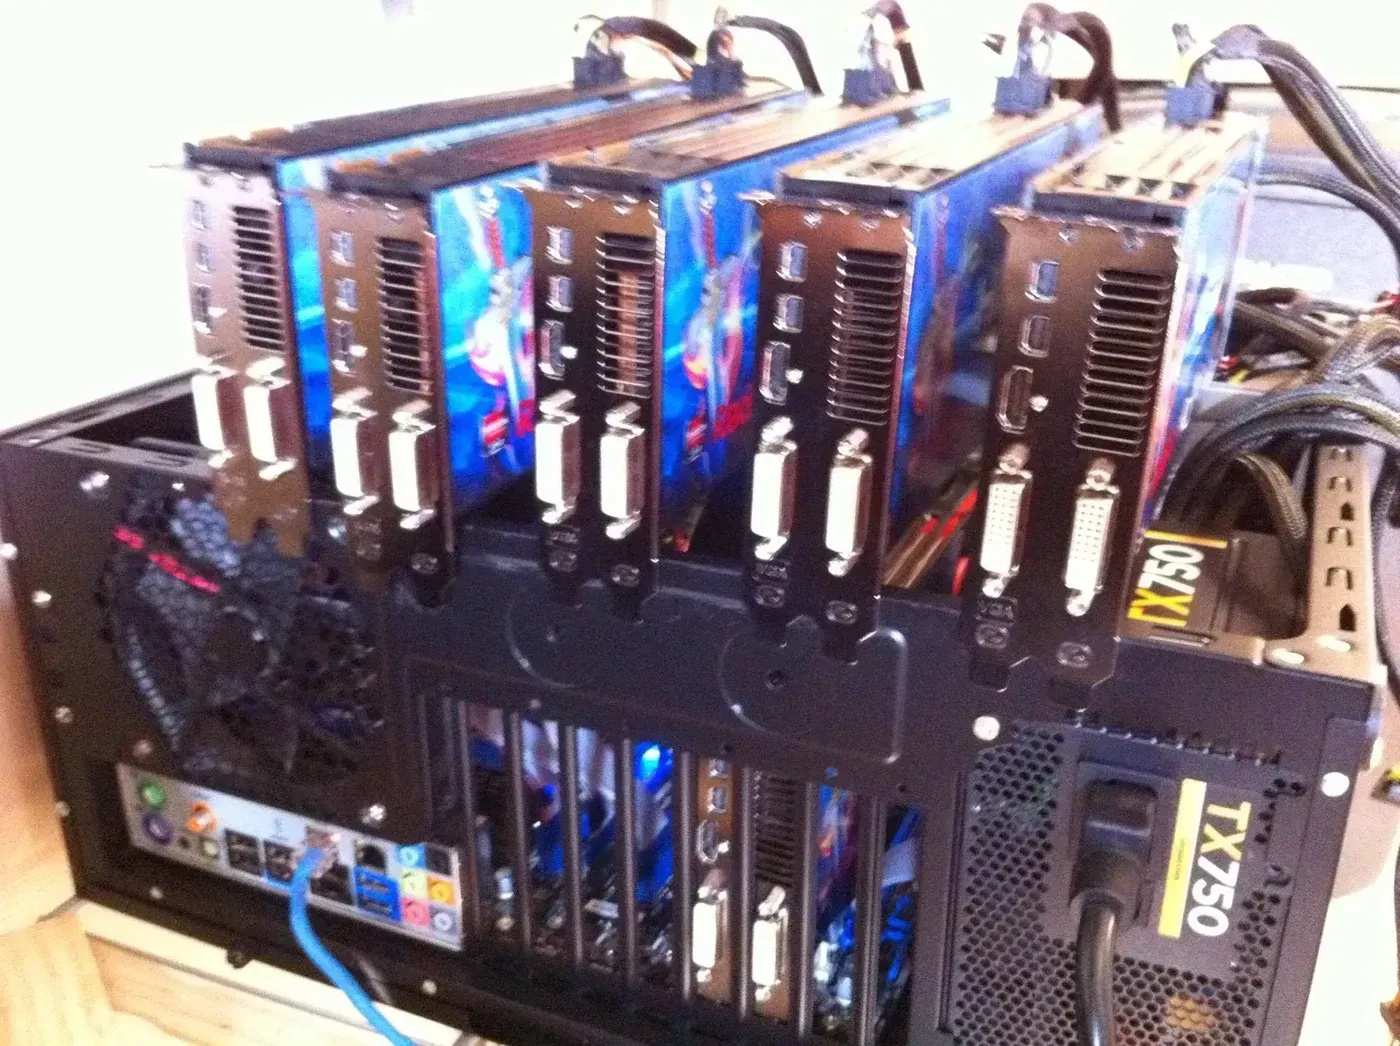
GPU 多卡礦機(開放式機架)
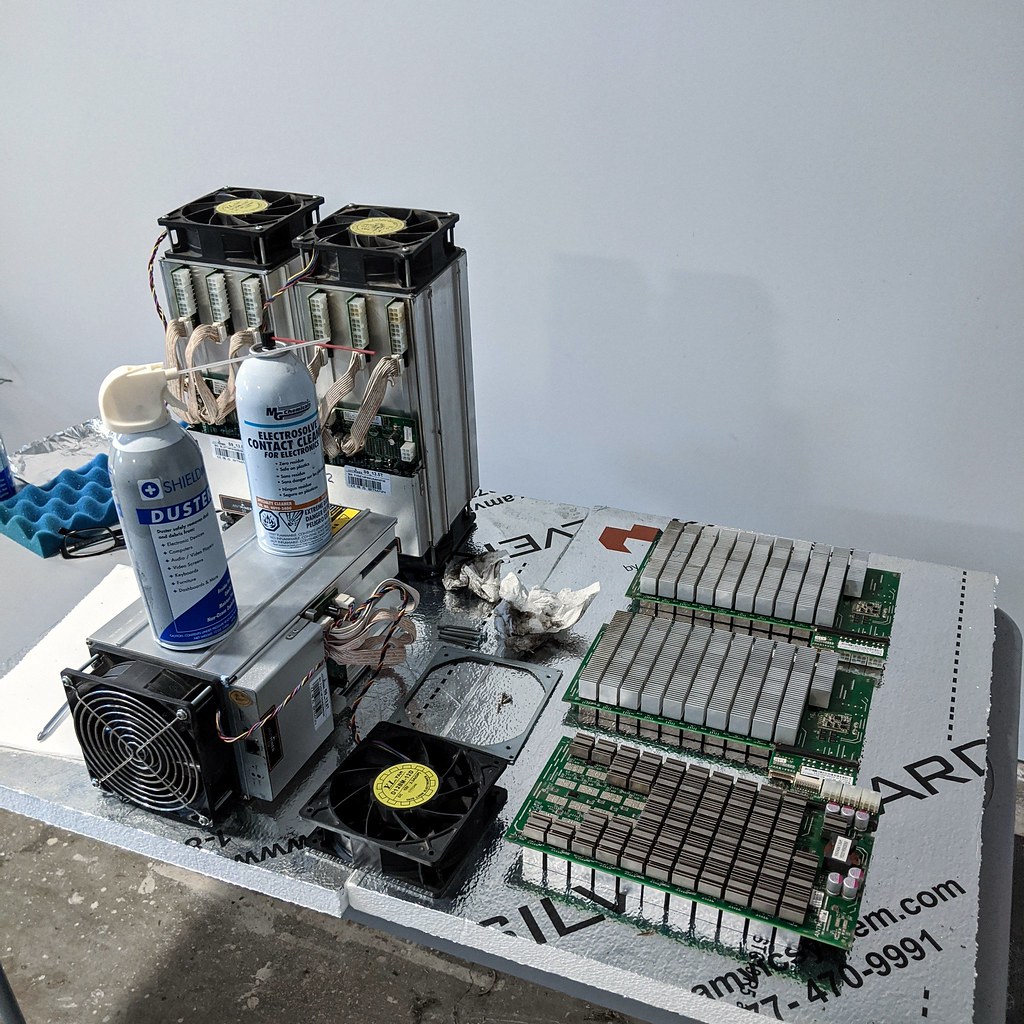
本代唯一不是產品、而是礦工自己組裝出來的形態。單卡不夠用之後,人們把多張顯示卡架上開放式框架,經 PCIe 延長線接同一塊主機板,外接大功率電源、拿工業風扇吹。挖礦由此從「一臺電腦」變成「一排顯示卡」——電費、散熱與機位第一次成為核心成本。今天礦場的一切邏輯,雛形都在這張桌子上。

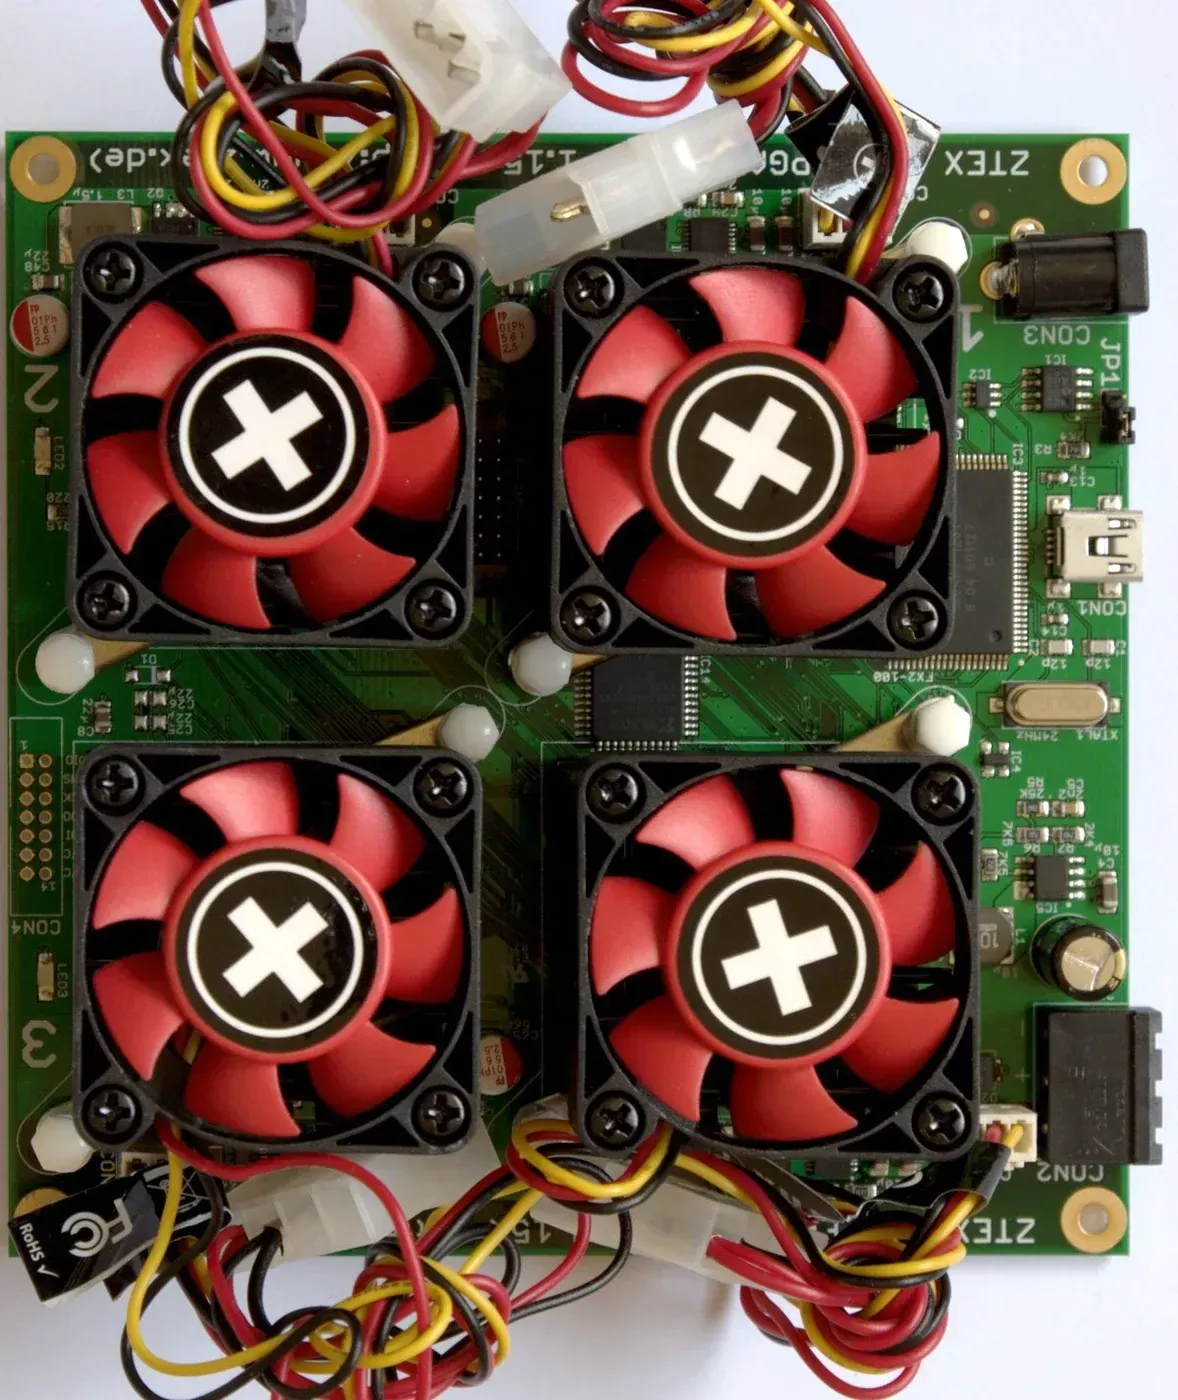
Icarus
開源的 FPGA 礦機,也是通向 ASIC 那條路的起點。2011 年,ngzhang 在 Bitcointalk 論壇發布 Icarus:一塊板上兩片 Spartan-6 LX150,約 380 MH/s,功耗約 19.2W——算力與 GPU 時代的 HD 5870(400 MH/s @ 約 190W)相當,功耗只有它的約十分之一。它的原理圖和工程檔案全部以 GPL 公開,任何人都可以照著做。FPGA 之所以是通向 ASIC 的橋,不在於它更快,而在於它證明了把 SHA-256 直接燒進電路能帶來數量級的能效躍遷。ngzhang 隨後走完了這條路:他發起的 Avalon 項目,造出了第一臺商用 ASIC 礦機 Avalon Batch 1。
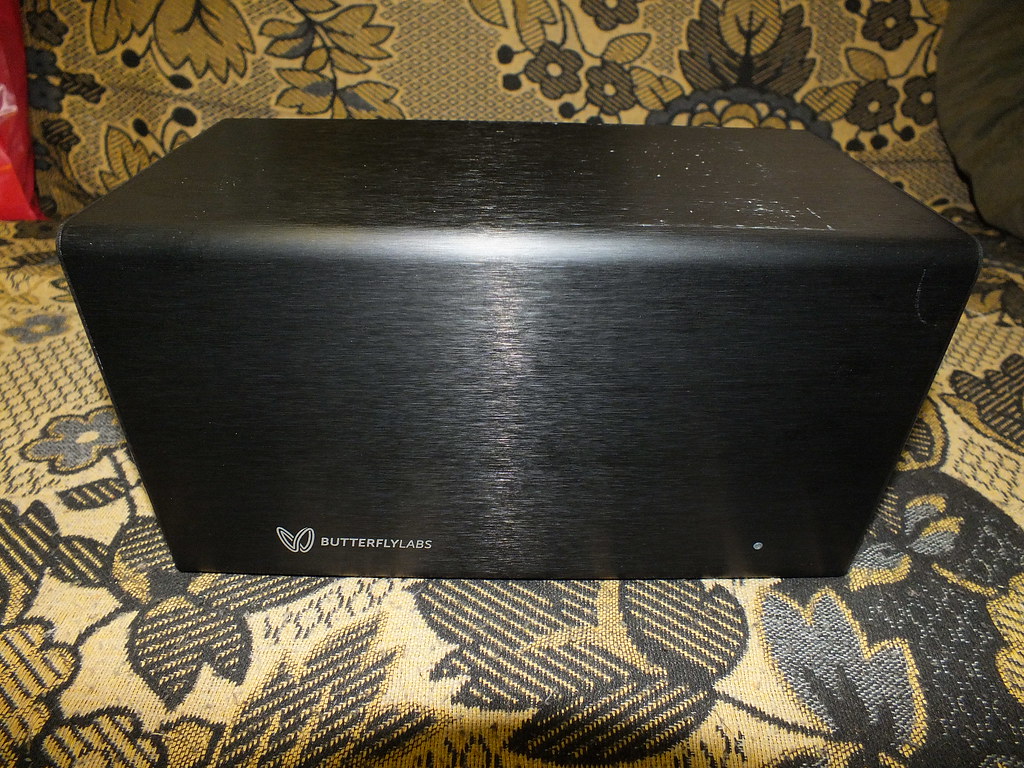
Butterfly Labs BitForce SHA256 Single
最早一批可以直接買到的整機式比特幣礦機之一。 Butterfly Labs 是最早一批把礦機當整機產品賣的公司之一——挖礦從此不必自己組裝,一個產業由此誕生,此後的位元大陸、嘉楠走的都是這條路。832 MH/s @ 80W:每瓦算力只有同代 Icarus 的一半左右,說明這一代內部的能效差距同樣懸殊。⚠ 該公司 2014 年因預售不發貨被 FTC 查處停業——產業化的另一面,本館一併陳列。
Canaan Avalon Batch 1
ASIC 時代的第一天。 專用晶片只做 SHA-256 一件事,能效碾壓所有前代——它一交付,FPGA 與顯示卡在一夜之間失去意義:66 GH/s 相當於 約 170 臺 Icarus——而發起 Avalon 的,正是發布 Icarus 的 ngzhang(張楠賡)。值得注意的是這一槍由嘉楠而非位元大陸打響:Avalon 搶先量產交付,而在此後數年內,主導權便轉向了位元大陸。首批僅約 300 臺,今已成收藏級文物。
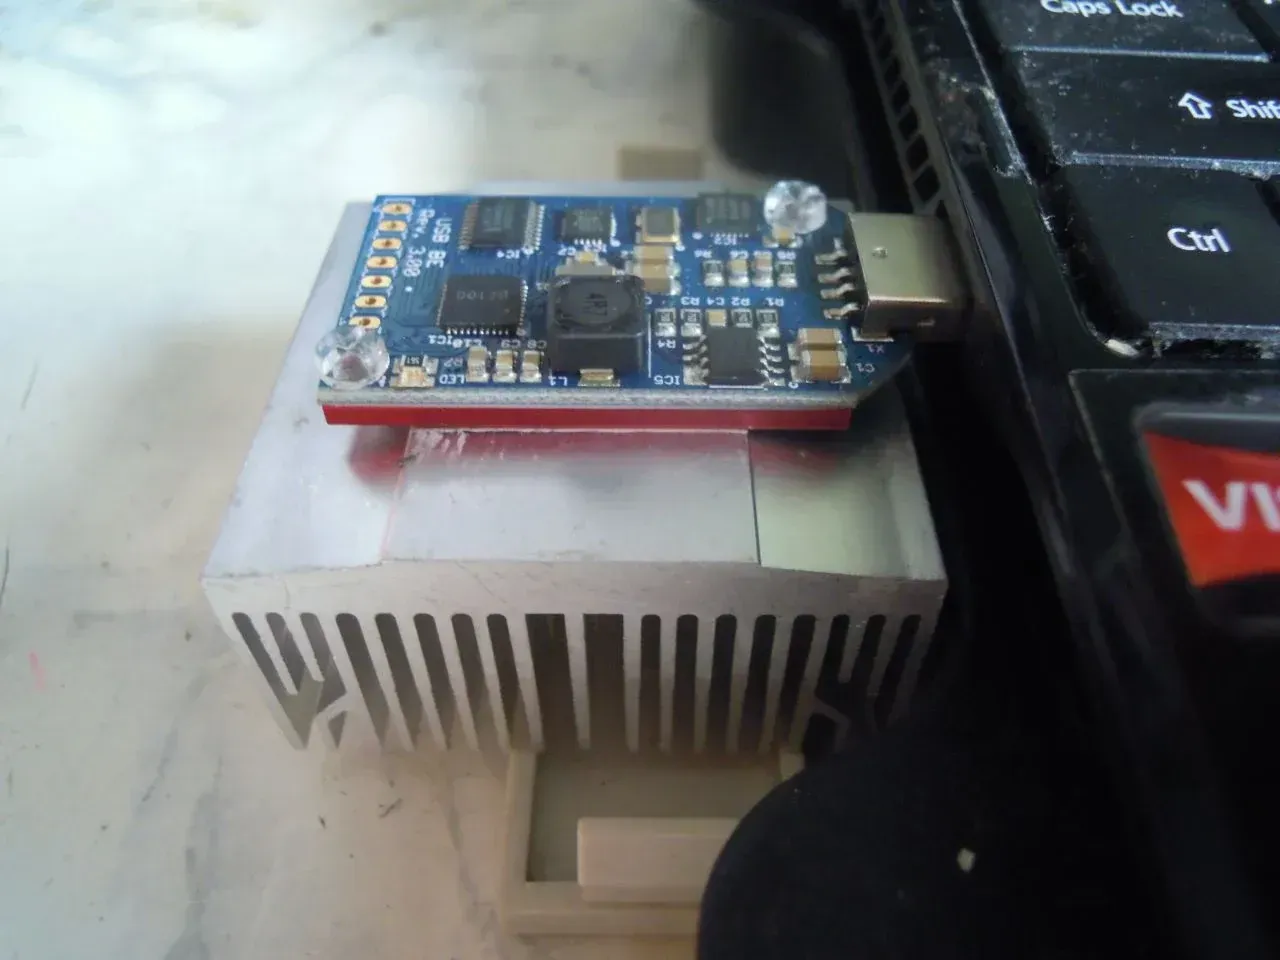
ASICMiner Block Erupter USB
一根隨身碟大小的礦機,插上就挖。它是「人人可參與」的最後一次嘗試——便宜到幾乎人人買得起,無需機架、無需專門電源。去殼後可以看清它有多簡單:一塊指甲大小的晶片,加一個 USB 埠,其餘空間幾乎全讓給了散熱。但 333 MH/s 在同年動輒數十 GH/s 的大機器面前很快歸零。本館展它,不是因為它強,而是因為它標記了散戶挖礦的終點:此後挖礦徹底成為資本與電力的生意。
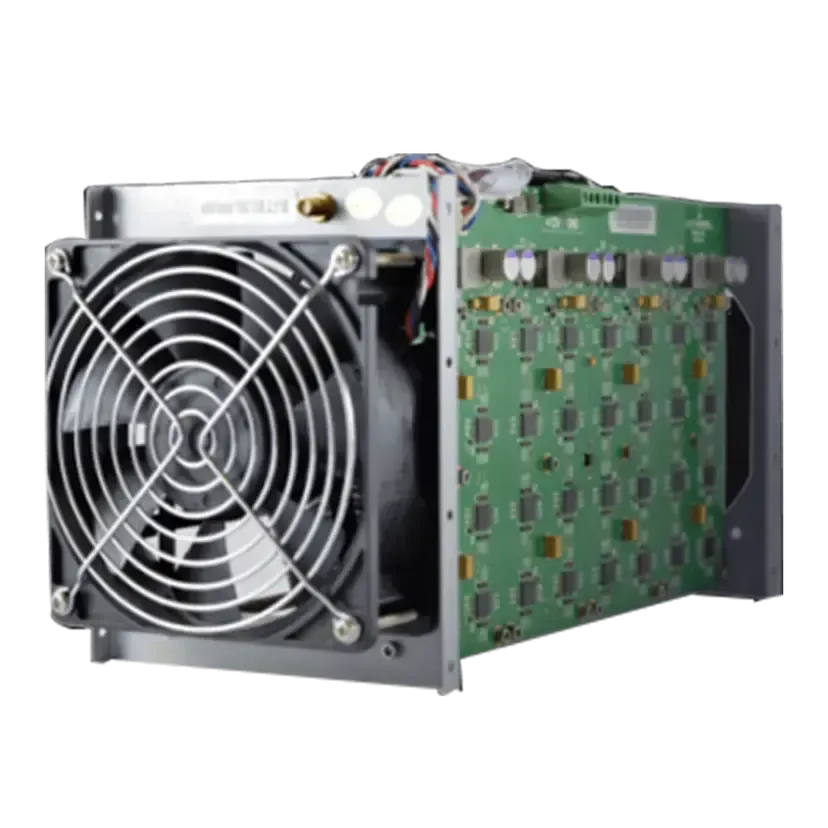
Bitmain Antminer S1
位元大陸的第一臺機器。 它本身並不特別出眾,重要性全在於它是一條長達十餘年品系的起點——S1 之後是 S3、S5、S7,直到 S9 成為史上部署最廣的礦機之一,再到 S21 與今天的 S23。這家 2013 年才入場的後來者,最終主導了全球算力供應。
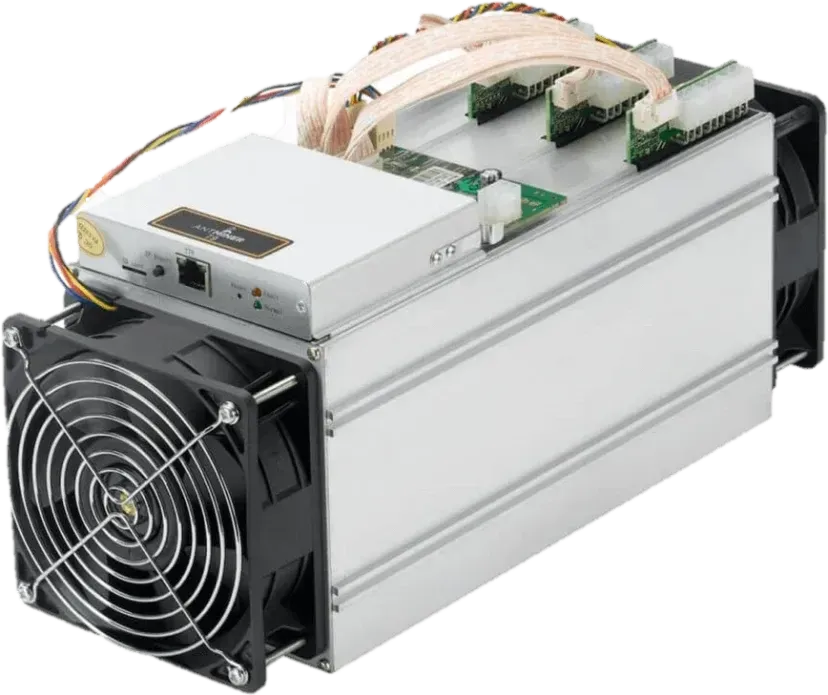
Bitmain Antminer S9
如果只能為一臺機器立傳,是它。 13.5 TH/s @ 1323W,2016 年上市後連續數年支撐起全網大部分算力,是史上部署最廣、服役最久的礦機之一——直到今天仍有 S9 在電價足夠低的地方運轉。它也定義了現代礦機的形態:銀色筒身、兩端風扇、只有一根網線和一根電源線,此後多數風冷礦機都沿用了這個樣子。
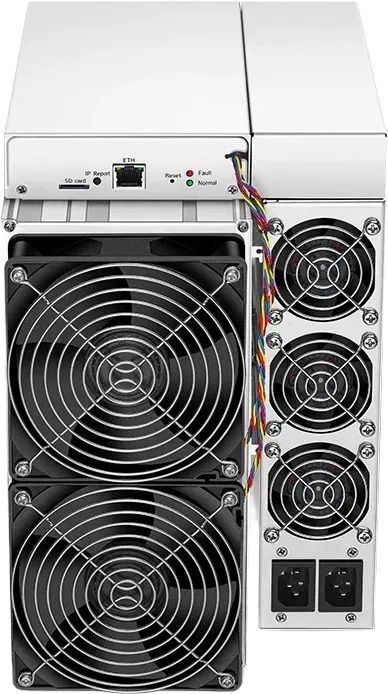
Bitmain Antminer S19 / S19 Pro / S19 XP
工業化礦場的標準配置。 從 95 到 140 TH/s 的三個型號覆蓋了不同電價與折舊策略,被成千上萬臺地部署進貨櫃與廠房。到這一代,礦機已不再按「臺」討論,而是按兆瓦——選型的關鍵變數從算力變成了每 TH 的功耗與回本週期。
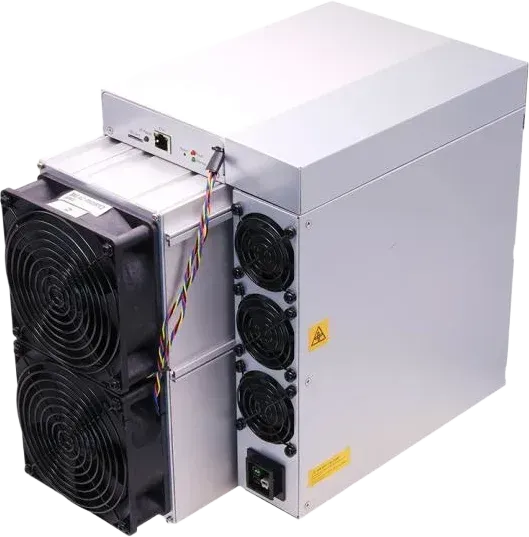
Bitmain Antminer S21
2023 年的世代旗艦。 200 TH/s——是 2016 年 S9 的近 15 倍,而 S9 又是 2013 年 Avalon Batch 1 的近 200 倍。把這三臺並排放在一起,就是十年間三千倍的算力躍遷,也是難度調整機制持續把出塊時間鎖在十分鐘的十年。
MicroBT Whatsminer M60S
位元大陸不再一家獨大的證據。 MicroBT 由前位元大陸晶片工程師創立,憑 Whatsminer 系列成為第二極,與 S 系列在能效上正面競爭。算力供應商的多元化直接關係到去中心化:若全球礦機只出自一家,這家公司對網路的潛在影響力將成為系統性風險。
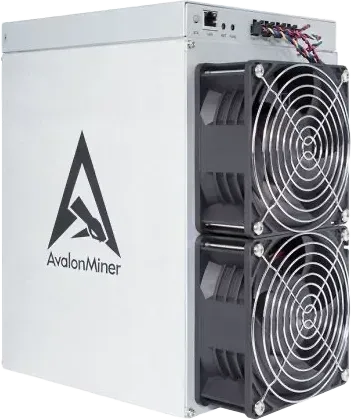
Canaan Avalon A1566
首尾呼應的一臺。 2013 年造出世界第一臺商用 ASIC 的正是嘉楠,十餘年後它仍在這個領域競逐。把 2023–24 年這一代的三臺旗艦並排比較,會看到一個與早期截然不同的局面——S21 17.5、M60S 18.5、A1566 18.5 J/TH:三家的能效差距已壓縮到小數點後,而 2013 年 Avalon 與 Antminer S1 之間的能效還相差四到五倍。競爭進入精算階段,這門生意的門檻也從「能不能做出晶片」變成了「每焦耳能多算多少」。
礦場
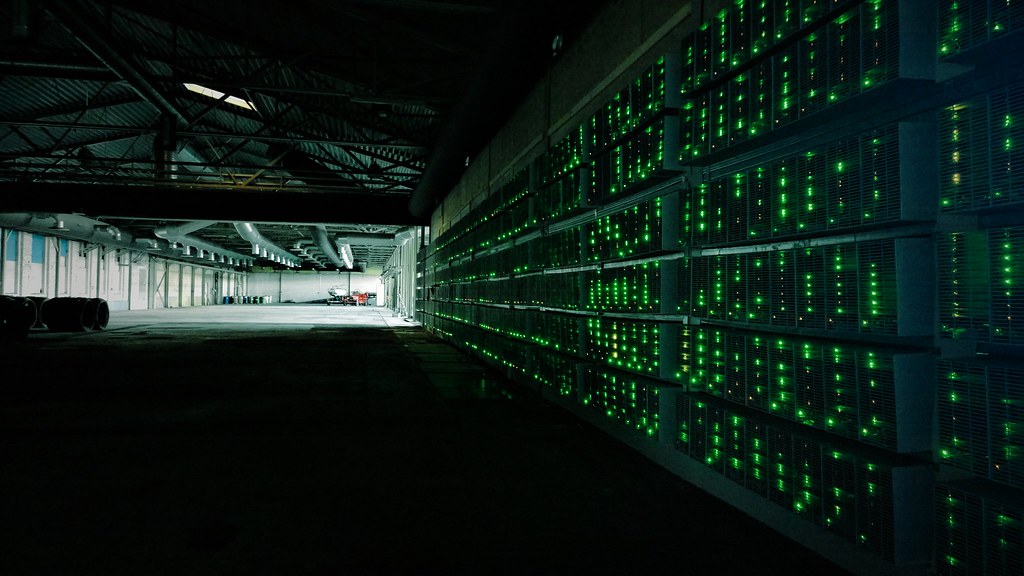
十七年間,挖礦的物理形態從一臺桌面電腦變成了以兆瓦計量的工業園區。驅動這場變化的不是算力本身,而是單位算力的成本——當出塊獎勵由協定固定、而競爭者不斷增加,唯一能拉開差距的就是把每一度電換成儘可能多的雜湊。這條約束依次重塑了設備、廠房、選址,最終把挖礦變成了一門電力生意。
家用設備
運行在個人電腦上,功耗百瓦量級,與普通家庭用電無異。此時不存在「礦場」這一形態:全網算力低,一臺機器仍有實際中獎機率,無須集中部署。
自建機房
GPU 多卡機架出現後,單機功耗升至千瓦量級,家庭線路與散熱開始成為限制。礦工轉向車庫、倉庫等可改造空間,第一次需要處理供電擴容與強制通風——這是「機房」問題的起點。
選址由電價主導
ASIC 把能效提高了數個數量級,也把熱密度推到必須專門設計的程度。設備成本可一次性攤銷,電費卻按月持續發生——從這一階段起,選址邏輯不再是「哪裡方便」,而是「哪裡的長期電價最低」。
工業化與金融化
園區規模以兆瓦計,出現託管(hosting)模式與上市礦企。部分營運方與電網簽訂可中斷供電協議,在電力緊張時段主動停機並獲得補償——挖礦由此從單純的用電方,變成了一種可調度的負載。
電價——營運成本的主項,直接決定盈虧平衡點。散熱條件——氣溫與冷卻方式共同決定為散熱額外付出的電力;風冷依賴環境溫度,水冷與浸沒式液冷則以更高的初裝成本換取更高的熱密度上限,並使餘熱回收成為可能。政策穩定性——設備一旦部署即難以短期遷移,因此監管的可預期性本身就是一項成本;2021 年之後,這一項在多數選址決策中的權重明顯上升。
中國全面清退挖礦後,當時佔全網近半(2021 年 4 月約 46%)的算力被迫在數月內跨境遷移。這是迄今對上述三個變數最直接的一次壓力測試:設備可以搬走,廉價電力與政策環境卻不能,因此遷移不是等距平移,而是向北美、中亞等地的重新聚集。網路本身未受影響——難度調整機制自動把出塊間隔拉回十分鐘。事件詳情見「榮耀與災難」。
礦業實際使用何種能源、其環境代價應如何權衡,是一個存在多方立場的開放議題。常被援引的說法包括「挖礦可消化棄電與擱淺能源」與「單筆交易能耗過高」,兩者各有其方法論前提,也各有批評。本館不在此作出判斷,在「文化與未來」的「能耗:PoW 值不值得」以三方並陳,各方均給出一手來源。
全網算力與難度增長史
從 CPU 時代的每秒數百萬次,到今天的每秒約十萬億億次(近 1,000 EH/s)——自 2009 年以來增長約十幾個數量級。這是一部軍備競賽的資料史,也是這本帳為什麼越來越難改的量化答案:算力就是帳本的護城河。
共識在行動
三次真實歷史事件價值溢位事件
2010 年 8 月 15 日,區塊 74638:一個整數溢位漏洞(數值超出程式能表示的範圍,繞回成錯誤的值)讓某人憑空造出了 約 1,845 億枚 BTC——遠超 2100 萬枚的上限。這本該是致命一擊。但約五小時內,修復版本發布,以軟分叉規則拒絕溢位交易;次日(8 月 16 日)不含這筆交易的鏈在區塊 74691 反超,成為最長鏈,壞鏈被徹底拋棄。這件事最值得記住:帳本會自我糾正,而稀缺由「規則 + 人」共同守護。
2013 意外分叉
2013 年 3 月,區塊 225430:新舊兩個版本的比特幣軟體對同一個區塊是否有效給出了不同判斷——這不是同時出塊造成的臨時分叉,而是規則執行出了分歧,網路意外分成兩條鏈。礦工們在數小時內協調把軟體降回舊版本,讓多數算力回到舊版本認可的那條鏈,網路重新統一。事後由 Gavin Andresen 撰寫的 BIP 50 事後分析報告,是研究「去中心化網路如何處理分歧」的重要一手文獻——它記錄了協調是怎麼發生的,也記錄了這套系統對人的依賴。

礦池與算力集中
單個礦工獨自挖到區塊就像中樂透——收入極不穩定。礦池把成千上萬礦工的算力匯聚起來,按貢獻分配獎勵,用穩定的小額收入換掉「等很久才中一次大獎」的劇烈波動。
但礦池也帶來了本廳最尖銳的問題:如果算力過度集中,「沒有誰說了算」還成立嗎?2014 年 6 月,礦池 GHash.io 的算力一度超過全網 50%(約 24 小時)。沒有攻擊發生——真正發生的是:社群公開施壓、礦工主動撤出算力,GHash.io 於同年 7 月承諾將份額上限控制在 39.99%。這次危機靠參與者的自我修正化解,而不是靠某個機構裁決。它也提示:算力去中心化需要持續維護,它不是自動的。
無需記帳人的帳本
剛才全程,沒有任何人拍板——是規則、密碼學和激勵在自動運作。沒有記帳人,同一筆錢也花不了兩次,陌生人依然能認同同一本改不了的帳。
關鍵事實
- 總量上限約 2,100 萬枚(實際略少,約 20,999,999.9769 枚),由共識規則規定,修改需全網接受新規則。
- 每 210,000 個區塊(約 4 年)獎勵減半一次。
- 平均約每 10 分鐘產出一個新區塊。
- 全球數萬個節點共同維護同一本帳。
- 要可靠地改寫帳本,須控制全網過半算力(51% 攻擊)。
- 挖礦硬體演進:CPU → GPU → FPGA → ASIC。