信任机器
从一台电脑到一座电厂,与写进代码的减半。光有理想不够,它得真的转起来。这一幕拆开比特币这台「信任机器」:矿工拼算力竞争记账,全球成千上万个节点各自独立校验同一套规则,记录越往后越改不动——于是没有中心,陌生人也能共享一本谁都赖不掉的账。
每一代真实矿机(CPU→GPU→FPGA→ASIC)· 全网算力与难度增长史 · 三次真实共识事件的一手报告与链上记录。
这本账之所以难以改写,是因为全网靠「算力竞赛 + 共识规则」共同维护同一本账——没有单一主体说了算,改写的代价随全网算力上升。这一论证也有已知的局限,见本厅「51% 攻击」展项中的「仍有争议的部分」。
一台机器如何运转
五个零件缺一不可信任机器总览
先见森林,再看树木。把这套系统当作互相咬合的齿轮——五个零件缺一不可,合起来才让「无需信任」成立。看完全貌,再进入下方各展项钻一个零件。
公共账本
一本人人可查、人人各存一份的账。
密码学链接
区块环环相扣,改一处则后面全废。
工作量证明
谁想记账,先付出真实算力与电力。
最长链共识
全网默认认可累积工作量最多的那条链。
激励设计
诚实记账有奖励,作弊成本远大于收益。
人类哈希挑战
哈希把任意数据压成一串固定长度的「指纹」,无法倒推。挖矿就是不停换一个数字重算哈希,直到碰上足够小的结果——没有捷径,只能硬试。疯狂点击,感受一下。
工作量证明与难度调整
算力涨了上百万亿倍,出块速度却始终约十分钟一个——因为规则会自己纠正。每 2016 个区块(约两周),全网根据前一轮的实际耗时自动调整难度:出块太快就调难,太慢就调易。没有委员会开会,没有人下命令,这是一套写进代码的自我调节机制。
减半大钟
距离下一次比特币减半,还有——
出块奖励——矿工每写入一个区块获得的新币,也是新币的唯一来源——每 21 万个区块减半一次:50 → 25 → 12.5 → 6.25 → 3.125 BTC。总量 2100 万枚的上限,不靠任何机构承诺,而是这条减半规则的数学后果。稀缺,是被代码执行的。
一笔交易如何在无人信任下被全网确认
跟随一笔真实交易走完全程。每一步只问一件事:这里本来该信任谁?——又是被什么机制替代了?
发起
你用私钥签名,证明「是我本人」。
广播
交易传遍全球节点,进内存池。
打包
矿工竞争算力,赢家打包进区块。
确认
全网同步,越往后越不可逆。
| 这里本来该信任谁 | 被什么机制替代了 | |
|---|---|---|
| 信任银行核对你的余额 | → | 全网公开账本 + 密码学签名 |
| 信任某人诚实记账 | → | PoW 算力竞争 + 最长链规则 |
| 信任大家不作弊 | → | 激励设计:作弊成本 > 收益 |
为什么这本账很难改写
从「同一笔钱花两次」说起双花问题的解答
数字信息能随意复制,一笔数字货币凭什么不能复制一份、花两次?过去靠银行这样的记账人核对余额;没有记账人怎么办?这就是「双花问题」。
中本聪的答案不是「找一个更可信的人」,而是「让时间顺序本身变得昂贵」。所有交易被公开广播、按顺序打包进区块,而写下一个区块必须付出真实的算力。想让同一笔钱花第二次,你就得推翻已经写好的顺序——也就是要重做那之后全部的工作量,并且跑得比全世界剩下的算力还快。双花没有被禁止,它只是被做成了一件在经济上划不来的事。
不可篡改性
每个区块的头部都写着上一个区块的哈希值。这意味着任何一个字节的改动,都会让它的哈希变样,从而让下一个区块指向的地址失效——连锁反应一直传到链尾。所以要改写第 N 个区块,你必须重做第 N 个之后所有区块的工作量,同时还要追上全网正在往前推进的速度。不是「不允许改」,是「改不动」。
哈希指针
每个区块头含前一区块哈希,篡改立刻暴露。
累积工作量
改一个区块,要重做其后全部 PoW——工作量随深度不断累加。
越久越硬
区块埋得越深,重写它需要的算力越接近不可能。
共识规则 · 节点在验证什么
这是全场最容易被误解的一点:矿工并不决定规则,节点才是。矿工只负责「提议」——把交易打包成区块。而全球每一个全节点都会独立地、逐条地校验这个区块:签名对不对、有没有双花、金额是否守恒、奖励有没有超发、区块大小是否合规。任何一条不过,区块直接被丢弃,无论提议者有多少算力。「不信任,去验证」不是一句口号,它是每个节点每十分钟都在做的事。
- 签名有效性
- 无双花
- 发行量守恒
- 工作量达标
签名有效性
每笔输入是否由对应私钥合法签署。
无双花
被花掉的 UTXO 是否确实未被动用过。
发行量守恒
出块奖励是否等于当前减半周期允许的额度。
工作量达标
区块哈希是否满足当前难度目标。
矿工提议,节点裁决。这就是为什么「算力大」不等于「说话算数」。2017 年的区块大小之争中,结局并非由矿工单方决定,各方作用至今仍有争议,经过见「荣耀与灾难」中的「区块大小之战」展项。
最长链规则与分叉收敛
两个矿工几乎同时挖出区块,网络会短暂地出现两条链——这不是故障,而是设计允许的常态。节点各自先接受先收到的那个,然后继续挖。下一个区块出现在哪一边,那一边就更长,另一边被抛弃,其中的区块成为「孤块」。分歧靠算力自动收敛,不需要任何仲裁者。这也解释了「确认数」:你的交易上面压了越多区块,被回滚所需的算力就越荒谬。
孤块 · 交易回到内存池
网络正常延伸
临时分叉
同时出块导致两条候选链,属正常现象。
孤块
落败那条链上的区块被全网丢弃,其交易回到内存池。
为什么等 6 个确认
每多一个确认,算力占少数的攻击者追上的概率就按指数下降——等待即安全。
记账大冒险 · 51% 攻击
想改写账本,靠的不是「多开几个节点」,而是算力。拖动滑块扮演攻击者——看看凑齐相应算力的代价,以及按白皮书 §11 的公式,这些算力换来的实际胜算是多少。
靠算力,不是靠开节点
跑一个节点很便宜,它只负责按规则校验交易;真正能改写账本的,是“谁的算力/工作量最多”。要可靠地发动攻击,必须掌握全网 >50% 的算力;算力不足一半也有成功可能,但概率随确认数增加迅速下降。
算力总量巨大,分布随时间变化
全网算力来自全球数以千计的矿工与矿池。要过半,需购置并运行超过其余所有参与者总和的 ASIC,硬件与电费达数百亿美元量级。但算力的集中程度并非恒定,矿池份额的历史变化见本厅「矿池与算力集中」。
即便做到也偷不到什么
你最多只能双花自己近期的交易、或暂时审查某些交易;无法凭空造币、无法偷走别人的币、无法改写久远的历史。
攻击的收益演算
白皮书第 6 节的论证是:即便掌握多数算力,按规则挖新币也比破坏系统更划算,因为系统一旦被破坏,攻击者自己的币也会贬值。后续文献(如 Budish 2018)补充:攻击还会让只能用来挖矿的矿机跟着贬值。这一论证在什么条件下成立,见下方「仍有争议的部分」。
越久的账越改不动
要推翻越早的区块,就得重做它之后的全部工作量,工作量随深度累加,少数算力追上的概率指数级下降;何况社区还能检测到异常并联手反制。
仍有争议的部分
上述五点是这一设计的主流论证,但并非定论。①「必须过半」受到质疑:Eyal 与 Sirer 2013 年提出的「自私挖矿」主张,在特定条件下低于 50% 的算力亦可获得超额收益。② 攻击者未必需要自建矿场:算力租赁市场使短时租用成为可能,以太坊经典与 Bitcoin Gold 上已实际发生过此类重组。③ 第 4 点的收益演算以攻击者持有矿机为前提;若其同时持有空头头寸,该演算不成立(Budish 2018)。本馆并陈这些论述,不就何者成立作出判断。
算力竞赛
从一台电脑到一座电厂矿机进化墙
从一台电脑到一座电厂——挖矿设备的进化史。CPU→GPU→FPGA→ASIC 四代,每代都因下一代更高的算力与能效比而被淘汰。
逐代机型编目 · 规格与来源
每台机器都注明规格出处与图像来源。

通用 x86 CPU · 示例 Intel Core i7-920
全墙唯一一件本身不是矿机的展品——一颗普通台式机处理器。中本聪正是用 CPU 挖出创世区块的。它的意义不在性能,而在门槛为零:任何有电脑的人都能参与,算力分布最均匀。这是比特币唯一一段「不必购置任何专门设备」的时期,此后再未重现。

AMD/ATI Radeon HD 5870
GPU 时代主力矿卡,并行架构算 SHA-256 比 CPU 快数十倍,一举让 CPU 挖矿失去意义。这一代矿工几乎只买 A 卡——AMD 的 VLIW 架构带 BFI_INT/bitalign 指令,单条指令即可完成 SHA-256 所需的位旋转,NVIDIA 要用三条,再加上运算单元更多,A 卡挖矿总体快 3–5 倍。挖矿自此与特定硬件绑定:买错牌子就挖不动。同期双芯旗舰 HD 5970 约 700 MH/s。
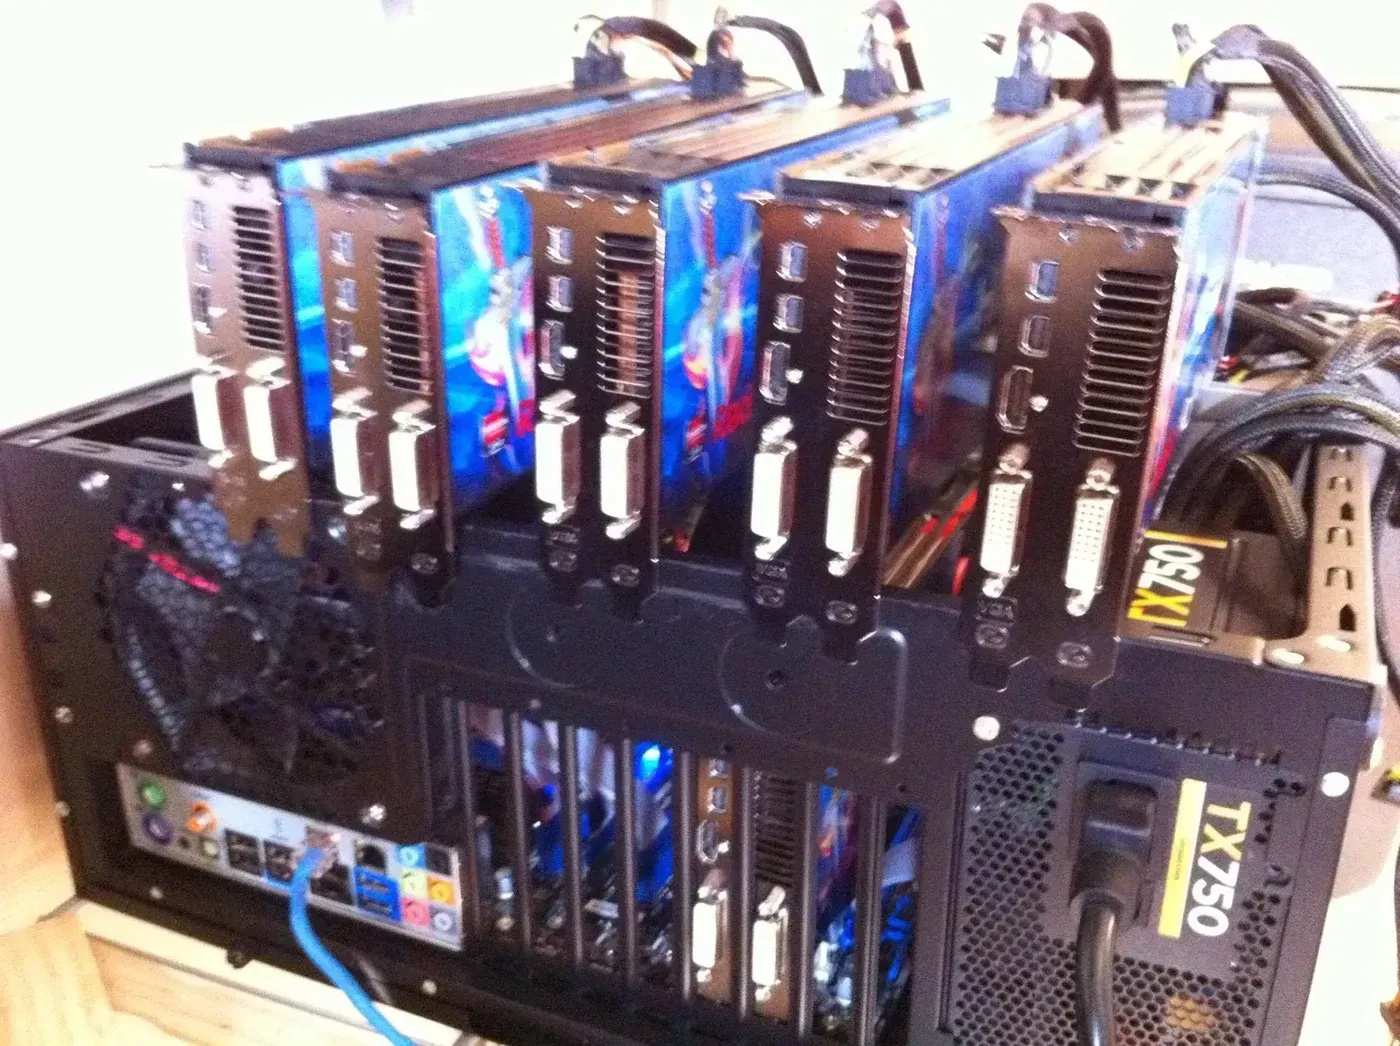
GPU 多卡矿机(开放式机架)
本代唯一不是产品、而是矿工自己攒出来的形态。单卡不够用之后,人们把多张显卡架上开放式框架,经 PCIe 延长线接同一块主板,外接大功率电源、拿工业风扇吹。挖矿由此从「一台电脑」变成「一排显卡」——电费、散热与机位第一次成为核心成本。今天矿场的一切逻辑,雏形都在这张桌子上。

Icarus
开源的 FPGA 矿机,也是通向 ASIC 那条路的起点。2011 年,ngzhang 在 Bitcointalk 论坛发布 Icarus:一块板上两片 Spartan-6 LX150,约 380 MH/s,功耗约 19.2W——算力与 GPU 时代的 HD 5870(400 MH/s @ 约 190W)相当,功耗只有它的约十分之一。它的原理图和工程文件全部以 GPL 公开,任何人都可以照着做。FPGA 之所以是通向 ASIC 的桥,不在于它更快,而在于它证明了把 SHA-256 直接烧进电路能带来数量级的能效跃迁。ngzhang 随后走完了这条路:他发起的 Avalon 项目,造出了第一台商用 ASIC 矿机 Avalon Batch 1。
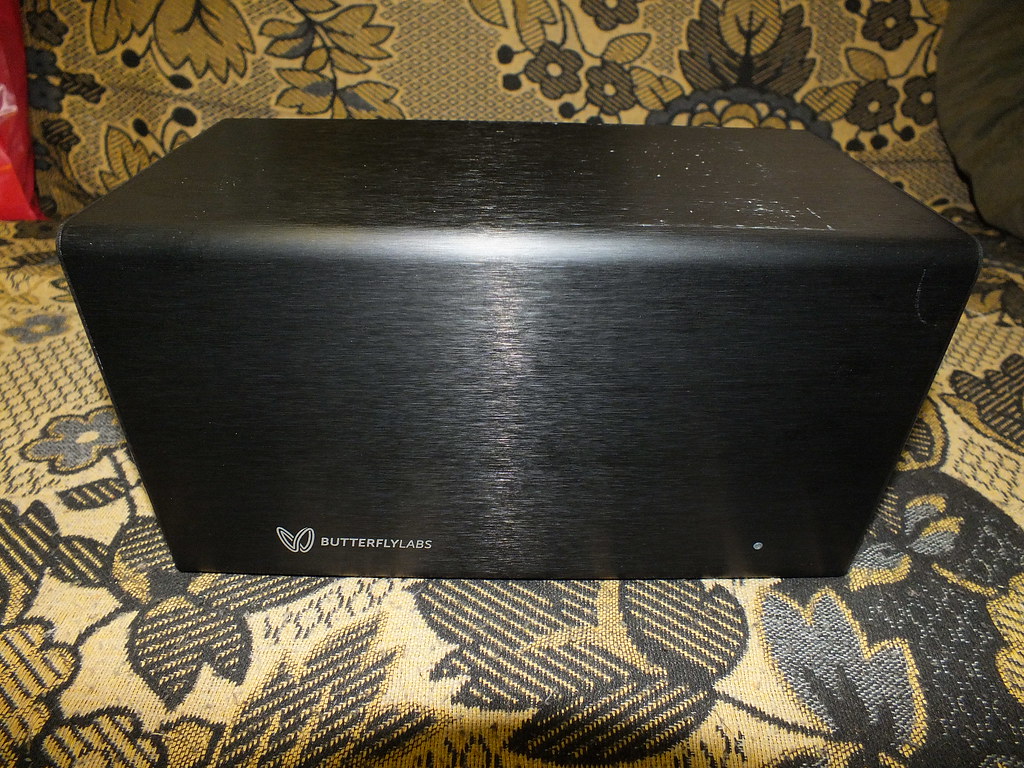
Butterfly Labs BitForce SHA256 Single
最早一批可以直接买到的整机式比特币矿机之一。 Butterfly Labs 是最早一批把矿机当整机产品卖的公司之一——挖矿从此不必自己攒,一个产业由此诞生,此后的比特大陆、嘉楠走的都是这条路。832 MH/s @ 80W:每瓦算力只有同代 Icarus 的一半左右,说明这一代内部的能效差距同样悬殊。⚠ 该公司 2014 年因预售不发货被 FTC 查处停业——产业化的另一面,本馆一并陈列。
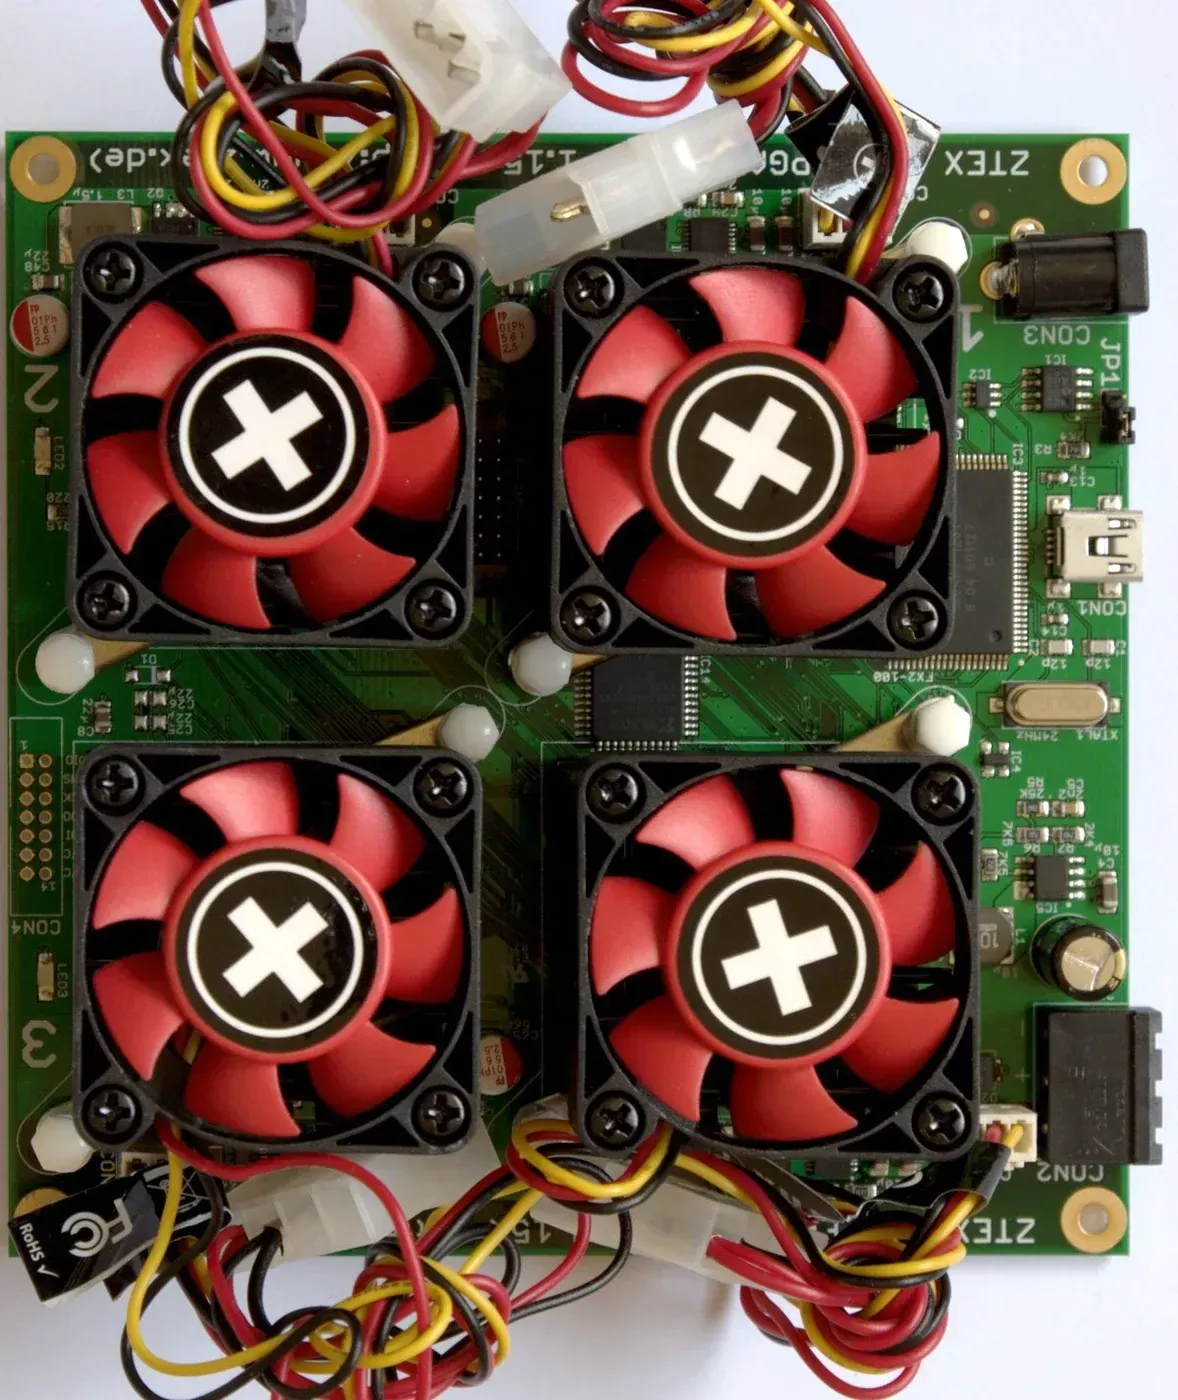
Canaan Avalon Batch 1
ASIC 时代的第一天。 专用芯片只做 SHA-256 一件事,能效碾压所有前代——它一交付,FPGA 与显卡在一夜之间失去意义:66 GH/s 相当于 约 170 台 Icarus——而发起 Avalon 的,正是发布 Icarus 的 ngzhang(张楠赓)。值得注意的是这一枪由嘉楠而非比特大陆打响:Avalon 抢先量产交付,而在此后数年内,主导权便转向了比特大陆。首批仅约 300 台,今已成收藏级文物。
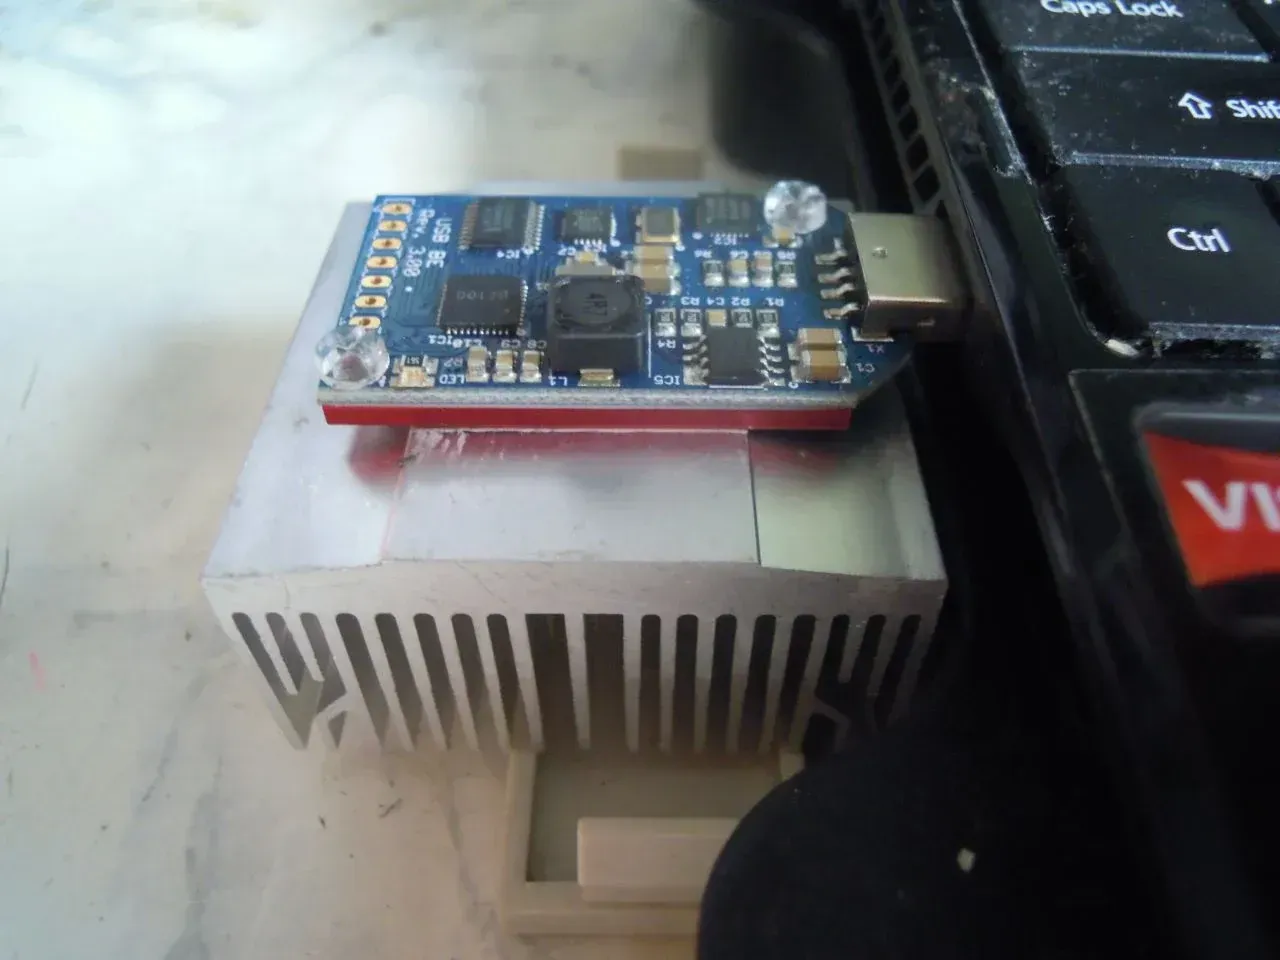
ASICMiner Block Erupter USB
一根 U 盘大小的矿机,插上就挖。它是「人人可参与」的最后一次尝试——便宜到几乎人人买得起,无需机架、无需专门电源。去壳后可以看清它有多简单:一块指甲盖大的芯片,加一个 USB 口,其余空间几乎全让给了散热。但 333 MH/s 在同年动辄数十 GH/s 的大机器面前很快归零。本馆展它,不是因为它强,而是因为它标记了散户挖矿的终点:此后挖矿彻底成为资本与电力的生意。
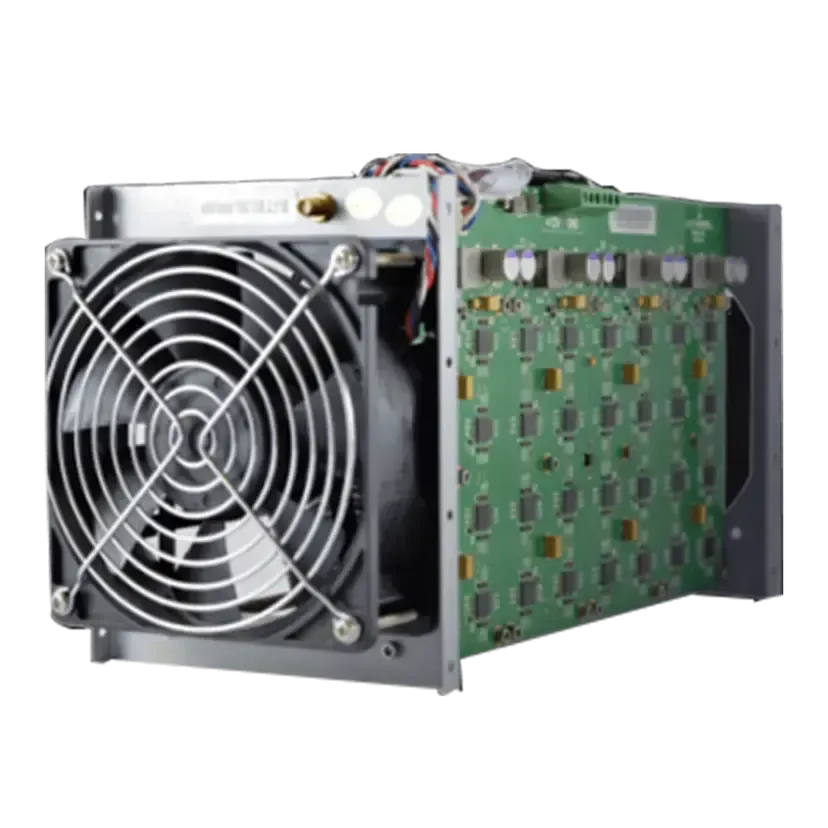
Bitmain Antminer S1
比特大陆的第一台机器。 它本身并不特别出众,重要性全在于它是一条长达十余年品系的起点——S1 之后是 S3、S5、S7,直到 S9 成为史上部署最广的矿机之一,再到 S21 与今天的 S23。这家 2013 年才入场的后来者,最终主导了全球算力供应。
Bitmain Antminer S9
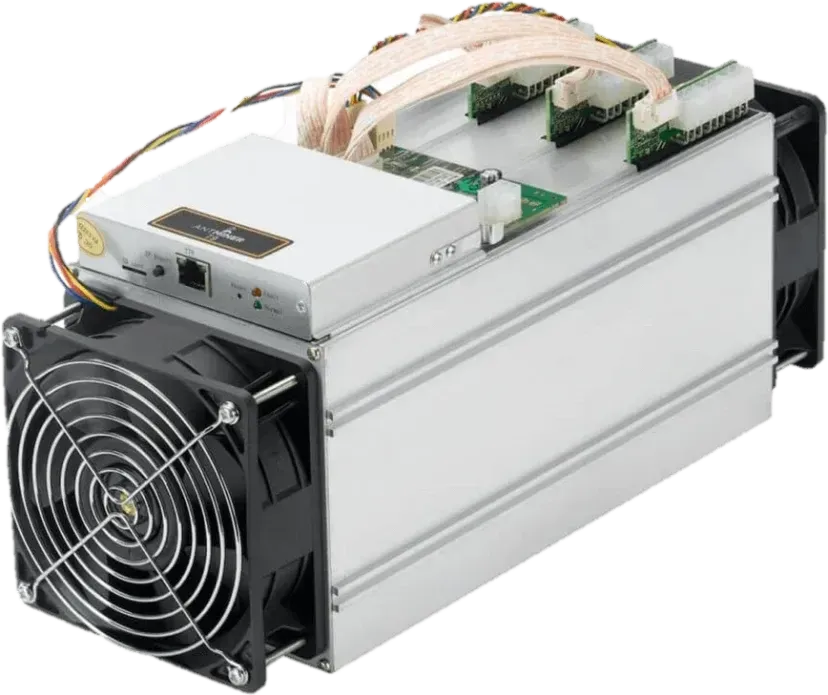
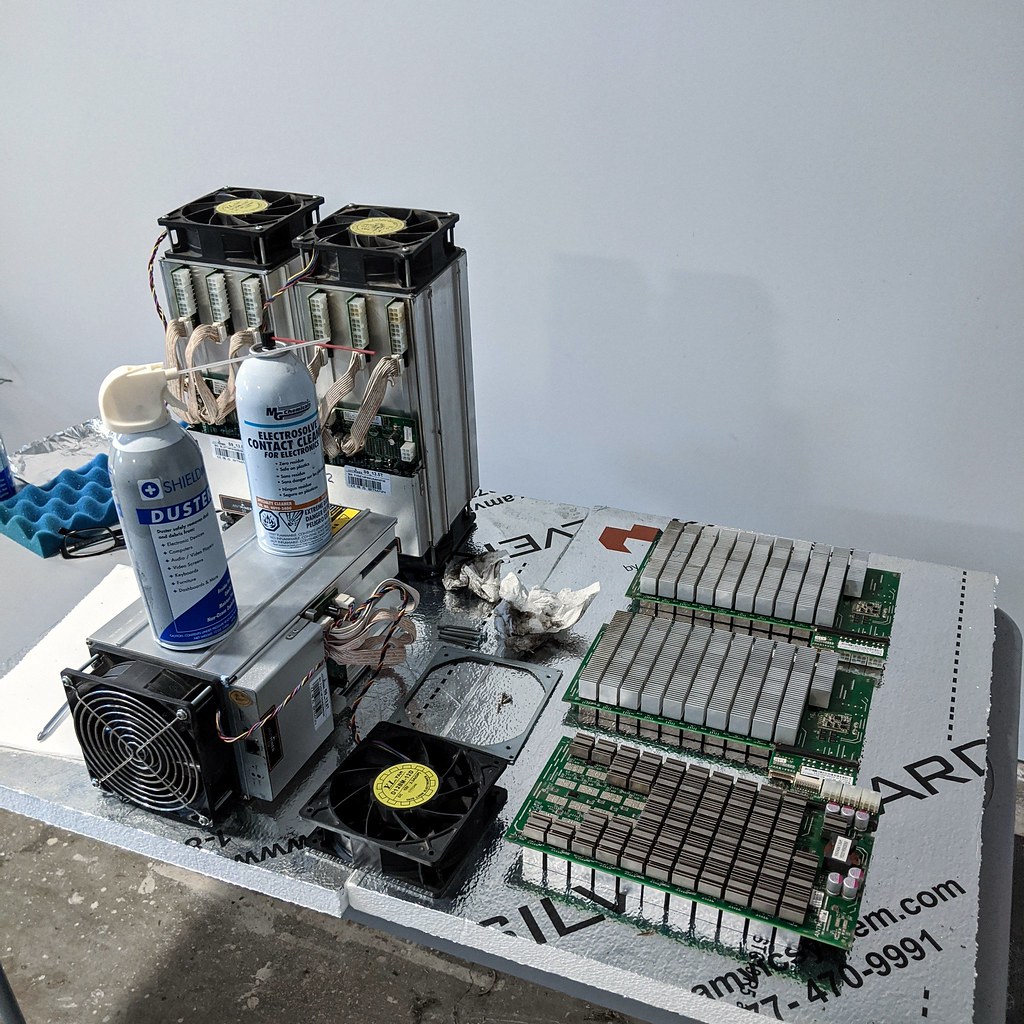
如果只能为一台机器立传,是它。 13.5 TH/s @ 1323W,2016 年上市后连续数年支撑起全网大部分算力,是史上部署最广、服役最久的矿机之一——直到今天仍有 S9 在电价足够低的地方运转。它也定义了现代矿机的形态:银色筒身、两端风扇、只有一根网线和一根电源线,此后多数风冷矿机都沿用了这个样子。
Bitmain Antminer S19 / S19 Pro / S19 XP
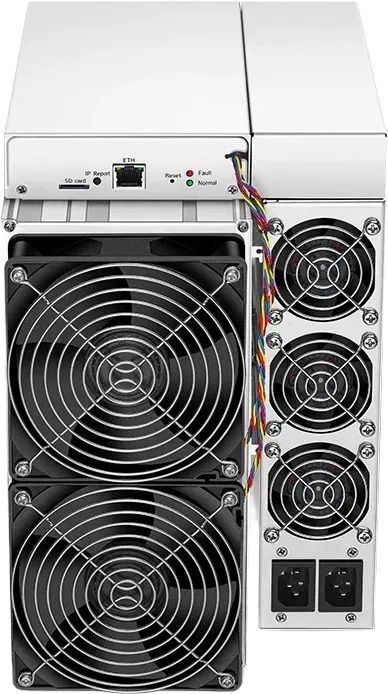
工业化矿场的标准配置。 从 95 到 140 TH/s 的三个型号覆盖了不同电价与折旧策略,被成千上万台地部署进集装箱与厂房。到这一代,矿机已不再按「台」讨论,而是按兆瓦——选型的关键变量从算力变成了每 TH 的功耗与回本周期。
Bitmain Antminer S21
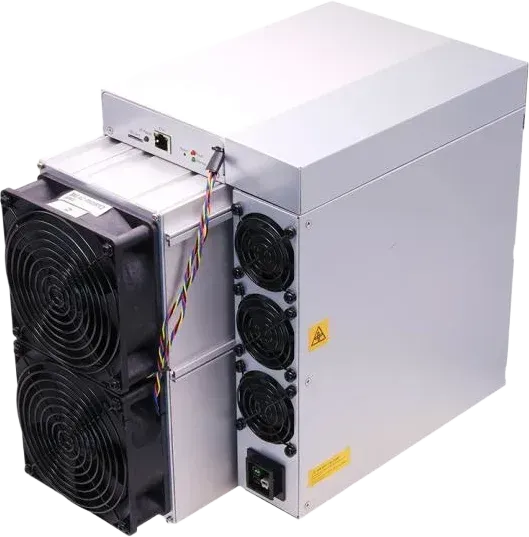
2023 年的世代旗舰。 200 TH/s——是 2016 年 S9 的近 15 倍,而 S9 又是 2013 年 Avalon Batch 1 的近 200 倍。把这三台并排放在一起,就是十年间三千倍的算力跃迁,也是难度调整机制持续把出块时间锁在十分钟的十年。
MicroBT Whatsminer M60S
比特大陆不再一家独大的证据。 MicroBT 由前比特大陆芯片工程师创立,凭 Whatsminer 系列成为第二极,与 S 系列在能效上正面竞争。算力供应商的多元化直接关系到去中心化:若全球矿机只出自一家,这家公司对网络的潜在影响力将成为系统性风险。
Canaan Avalon A1566
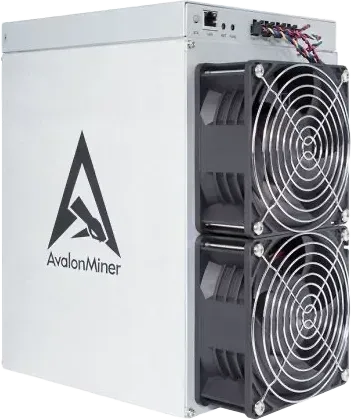
首尾呼应的一台。 2013 年造出世界第一台商用 ASIC 的正是嘉楠,十余年后它仍在这条赛道上。把 2023–24 年这一代的三台旗舰并排比较,会看到一个与早期截然不同的局面——S21 17.5、M60S 18.5、A1566 18.5 J/TH:三家的能效差距已压缩到小数点后,而 2013 年 Avalon 与 Antminer S1 之间的能效还相差四到五倍。竞争进入精算阶段,这门生意的门槛也从「能不能做出芯片」变成了「每焦耳能多算多少」。
矿场
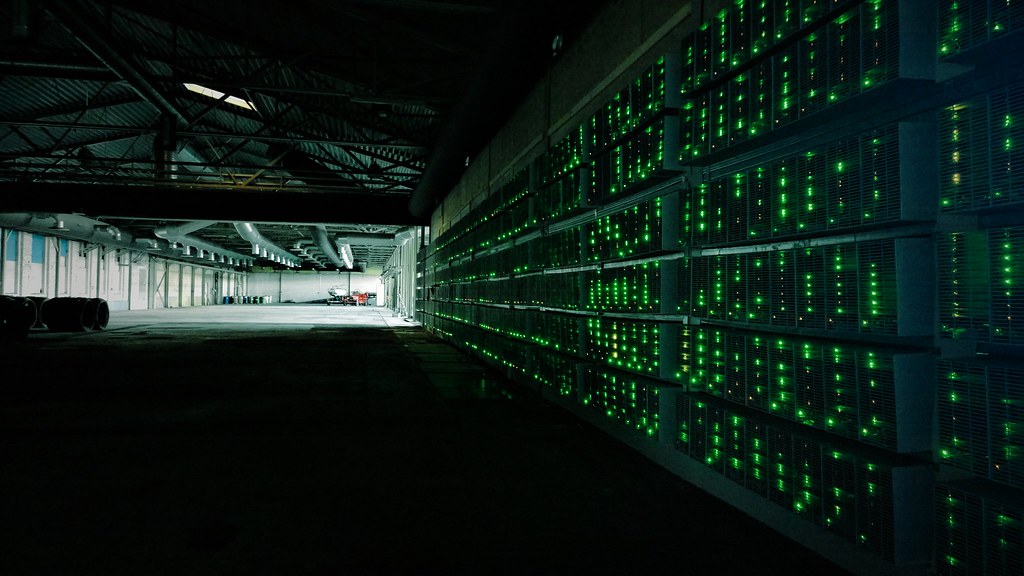
十七年间,挖矿的物理形态从一台桌面电脑变成了以兆瓦计量的工业园区。驱动这场变化的不是算力本身,而是单位算力的成本——当出块奖励由协议固定、而竞争者不断增加,唯一能拉开差距的就是把每一度电换成尽可能多的哈希。这条约束依次重塑了设备、厂房、选址,最终把挖矿变成了一门电力生意。
家用设备
运行在个人电脑上,功耗百瓦量级,与普通家庭用电无异。此时不存在「矿场」这一形态:全网算力低,一台机器仍有实际中奖概率,无须集中部署。
自建机房
GPU 多卡机架出现后,单机功耗升至千瓦量级,家庭线路与散热开始成为限制。矿工转向车库、仓库等可改造空间,第一次需要处理供电扩容与强制通风——这是「机房」问题的起点。
选址由电价主导
ASIC 把能效提高了数个数量级,也把热密度推到必须专门设计的程度。设备成本可一次性摊销,电费却按月持续发生——从这一阶段起,选址逻辑不再是「哪里方便」,而是「哪里的长期电价最低」。
工业化与金融化
园区规模以兆瓦计,出现托管(hosting)模式与上市矿企。部分运营方与电网签订可中断供电协议,在电力紧张时段主动停机并获得补偿——挖矿由此从单纯的用电方,变成了一种可调度的负荷。
电价——运营成本的主项,直接决定盈亏平衡点。散热条件——气温与冷却方式共同决定为散热额外付出的电力;风冷依赖环境温度,水冷与浸没式液冷则以更高的初装成本换取更高的热密度上限,并使余热回收成为可能。政策稳定性——设备一旦部署即难以短期迁移,因此监管的可预期性本身就是一项成本;2021 年之后,这一项在多数选址决策中的权重明显上升。
中国全面清退挖矿后,当时占全网近半(2021 年 4 月约 46%)的算力被迫在数月内跨境迁移。这是迄今对上述三个变量最直接的一次压力测试:设备可以搬走,廉价电力与政策环境却不能,因此迁移不是等距平移,而是向北美、中亚等地的重新聚集。网络本身未受影响——难度调整机制自动把出块间隔拉回十分钟。事件详情见「荣耀与灾难」。
矿业实际使用何种能源、其环境代价应如何权衡,是一个存在多方立场的开放议题。常被援引的说法包括「挖矿可消化弃电与搁浅能源」与「单笔交易能耗过高」,两者各有其方法论前提,也各有批评。本馆不在此作出判断,在「文化与未来」的「能耗:PoW 值不值得」以三方并陈,各方均给出一手来源。
全网算力与难度增长史
从 CPU 时代的每秒数百万次,到今天的每秒约十万亿亿次(近 1,000 EH/s)——自 2009 年以来增长约十几个数量级。这是一部军备竞赛的数据史,也是这本账为什么越来越难改的量化答案:算力就是账本的护城河。
共识在行动
三次真实历史事件价值溢出事件
2010 年 8 月 15 日,区块 74638:一个整数溢出漏洞(数值超出程序能表示的范围,绕回成错误的值)让某人凭空造出了约 1,845 亿枚 BTC——远超 2100 万枚的上限。这本该是致命一击。但约五小时内,修复版本发布,以软分叉规则拒绝溢出交易;次日(8 月 16 日)不含这笔交易的链在区块 74691 反超,成为最长链,坏链被彻底抛弃。这件事最值得记住:账本会自我纠正,而稀缺由「规则 + 人」共同守护。
2013 意外分叉
2013 年 3 月,区块 225430:新旧两个版本的比特币软件对同一个区块是否有效给出了不同判断——这不是同时出块造成的临时分叉,而是规则执行出了分歧,网络意外分成两条链。矿工们在数小时内协调把软件降回旧版本,让多数算力回到旧版本认可的那条链,网络重新统一。事后由 Gavin Andresen 撰写的 BIP 50 事后分析报告,是研究「去中心化网络如何处理分歧」的重要一手文献——它记录了协调是怎么发生的,也记录了这套系统对人的依赖。

矿池与算力集中
单个矿工爆块像中彩票——收入极不稳定。矿池把成千上万矿工的算力汇聚起来,按贡献分配奖励,用稳定的小额收入换掉「等很久才中一次大奖」的方差。
但矿池也带来了本厅最尖锐的问题:如果算力过度集中,「没有谁说了算」还成立吗?2014 年 6 月,矿池 GHash.io 的算力一度超过全网 50%(约 24 小时)。没有攻击发生——真正发生的是:社区公开施压、矿工主动撤出算力,GHash.io 于同年 7 月承诺将份额上限控制在 39.99%。这次危机靠参与者的自我修正化解,而不是靠某个机构裁决。它也提示:算力去中心化需要持续维护,它不是自动的。
无需记账人的账本
刚才全程,没有任何人拍板——是规则、密码学和激励在自动运作。没有记账人,同一笔钱也花不了两次,陌生人依然能认同同一本改不了的账。
关键事实
- 总量上限约 2,100 万枚(实际略少,约 20,999,999.9769 枚),由共识规则规定,修改需全网接受新规则。
- 每 210,000 个区块(约 4 年)奖励减半一次。
- 平均约每 10 分钟产出一个新区块。
- 全球数万个节点共同维护同一本账。
- 要可靠地改写账本,须控制全网过半算力(51% 攻击)。
- 挖矿硬件演进:CPU → GPU → FPGA → ASIC。